
Секционирование в MySQL: как масштабировать базу данных и не сломать логику
 ноя, 10 2026
Представьте ситуацию: у вас есть таблица с миллиардом строк. Запросы летают, пока данные горячие и лежат в оперативке. Но стоит историческим данным накопиться, как каждый `SELECT` превращается в пытку для диска. Знакомо? Именно здесь на сцену выходит секционирование (или партиционирование) - метод, который разбивает огромную логическую таблицу на физические куски. Звучит как панацея для всех проблем масштабирования, но давайте честно: это не серебряная пуля. У этого инструмента есть жесткие рамки, которые могут неожиданно ограничить вашу архитектуру.
Многие разработчики думают, что добавление `PARTITION BY` решит все проблемы с производительностью автоматически. Спойлер: нет. Иногда оно даже замедляет работу, если вы неправильно выбрали ключ разбиения. В этой статье мы разберем, когда секционирование действительно спасает проект, а когда становится лишним грузом, и какие технические ограничения MySQL вам придется учитывать при проектировании схемы данных.
Что такое секционирование и зачем оно нужно
Секционирование в MySQL - это механизм хранения данных одной таблицы в нескольких физических файлах или областях, управляемых движком InnoDB или MyISAM. Для приложения это выглядит как одна обычная таблица, но под капотом сервер знает, где искать нужные строки быстрее всего. Главная цель - не просто «разбить данные», а оптимизировать операции ввода-вывода и управление жизненным циклом данных.
Зачем это нужно на практике? Допустим, вы ведете журнал транзакций интернет-магазина. Последние 3 месяца данные активно читаются и пишутся. Данные старше года почти никто не трогает, кроме отчетов за прошлый год. Если вся эта история лежит в одном индексе B-tree, размер индекса растет, кэш процессора (CPU cache) чаще промахивается, а запросы сканируют ненужные страницы памяти. Секционирование позволяет отбросить старые разделы из поиска мгновенно, используя технику partition pruning (отсечение разделов).
| Аспект | Положительный эффект | Риск или ограничение |
|---|---|---|
| Производительность выборок | Быстрый поиск по диапазону дат или ID раздела | Замедление при запросах без условия по ключу секционирования |
| Управление данными | Мгновенное удаление старых данных через DROP PARTITION | Невозможность быстрого удаления произвольных строк из середины истории |
| Индексация | Более мелкие индексы лучше помещаются в RAM | Вторичные индексы должны включать ключ секционирования |
| Резервное копирование | Возможность бэкапить отдельные разделы | Сложность координации бэкапов между разделами |
Типы секционирования и выбор стратегии
MySQL поддерживает несколько стратегий разбиения, но на практике вы будете использовать одну из двух основных. Выбор зависит от того, как именно ваши пользователи обращаются к данным.
- RANGE (Диапазон): Самый популярный тип для временных рядов. Вы разбиваете таблицу по датам или числовым диапазонам (например, месяц за месяцем). Идеально подходит для логов, заказов, метрик мониторинга. Логика проста: если запрос фильтрует данные за октябрь, MySQL игнорирует разделы за сентябрь и ноябрь.
- HASH / KEY: Используется для равномерного распределения нагрузки. Ключ секционирования хешируется, и строка попадает в один из N разделов. Это полезно, когда нужно равномерно распределить нагрузку на диск, но сложно предсказать, какие именно данные будут читаться вместе. Часто применяется для балансировки нагрузки в кластерах.
Есть также LIST (по перечислению значений, например, по регионам) и COLUMNS (расширение RANGE для нескольких столбцов), но они встречаются реже. Главное правило: ключ секционирования должен быть частью первичного ключа или уникального индекса. Если у вас уникальный индекс по email, а секционируете вы по дате регистрации, вам придется добавить дату в уникальный индекс, что может нарушить бизнес-логику uniqueness.
Жесткие ограничения, о которых молчат туториалы
Вот тут начинается самое интересное. Документация MySQL часто сухо перечисляет ограничения, но реальная боль возникает, когда вы уже написали код. Давайте разберем три самых критичных момента.
1. Требование к ключу секционирования
Каждый уникальный индекс (включая PRIMARY KEY) обязан содержать все столбцы, используемые в выражении секционирования. Это звучит абстрактно, но на практике ломает многие схемы.
Пример: у вас есть таблица пользователей с `id` (PRIMARY KEY) и `email` (UNIQUE INDEX). Вы хотите секционировать таблицу по году создания (`created_at`). Вам придется изменить структуру так, чтобы `email` больше не был глобально уникальным сам по себе, либо сделать составной уникальный индекс `(email, created_at)`. Но тогда два пользователя смогут зарегистрироваться с одним email в разные годы! Придется проверять уникальность на уровне приложения или отказываться от секционирования этой конкретной таблицы.
2. Отсутствие поддержки внешних ключей (Foreign Keys)
Если ваша таблица является дочерней и ссылается на родительскую через FOREIGN KEY, вы не сможете её секционировать. И наоборот, если таблица имеет внешние ключи, указывающие на неё, она тоже не подлежит секционированию. MySQL просто запрещает такую комбинацию.
Это серьезное архитектурное ограничение. Многие монолитные приложения полагаются на целостность данных через FK. Переход на секционированные таблицы означает переход к прикладной целостности данных. Теперь вы сами должны гарантировать, что в таблице `orders` нет ссылок на удаленных пользователей. Это требует тщательного тестирования и часто приводит к появлению «осиротевших» записей.
3. Ограничение на количество разделов
Максимальное количество разделов в одной таблице - 8192. Может показаться, что это много, но если вы секционируете по дням, то 8192 дня - это более 22 лет. А если вы используете субпартиционирование (разбиение внутри разделов), эффективный лимит падает еще ниже. Кроме того, каждый раздел имеет свои накладные расходы на обслуживание метаданных. Слишком большое количество мелких разделов может замедлить открытие таблицы сервером.
Когда секционирование не помогает (или вредит)
Частая ошибка - пытаться секционировать таблицу, которая используется для случайных выборок по вторичным атрибутам. Представьте каталог товаров. Вы секционировали его по категории товара. Но пользователи часто ищут товары по названию, игнорируя категорию. В таком случае MySQL будет вынужден просканировать все разделы, потому что условие `WHERE name LIKE '%iphone%'` не позволяет отбросить ни одного раздела. Производительность упадет, так как сервер откроет дескрипторы файлов для каждого раздела вместо одного.
Также стоит помнить про стоимость операций JOIN. Если вы соединяете секционированную таблицу с несекционированной, оптимизатор может выбрать неоптимальный план. Например, он может решить сначала отфильтровать большую таблицу, а потом делать lookup в маленькую, игнорируя возможность partition pruning на стороне большой таблицы, если условие фильтрации не проходит прямо в `ON` или `WHERE` части запроса.
Практические советы по внедрению
Перед тем как бежать в продакшен с новым DDL, проведите аудит ваших запросов. Используйте `EXPLAIN PARTITIONS` (или просто `EXPLAIN FORMAT=JSON` в новых версиях MySQL 8.0+), чтобы увидеть, какие разделы реально затрагиваются запросом. Если поле `partitions` содержит список всех разделов - ваше секционирование бесполезно для этого конкретного запроса.
- Выбирайте правильный ключ: Даты (RANGE) работают лучше всего для архивации. Хеши (KEY) - для равномерного распределения нагрузки на запись.
- Проверяйте уникальные индексы: Заранее спроектируйте схему так, чтобы ключ секционирования входил во все уникальные ограничения.
- Готовьте скрипты обслуживания: Автоматизируйте создание новых разделов (например, ежемесячно) и удаление старых. В MySQL нет встроенного планировщика для автоматического ротации разделов, как в некоторых других СУБД.
- Тестируйте на реальных объемах: Не проверяйте эффективность на таблице с 10 тысячами строк. Эффект виден только когда объем данных превышает размер буферного пула InnoDB.
Еще один нюанс: статистика. Оптимизатор MySQL собирает статистику по каждому разделу отдельно. Если данные в разделах сильно дисбалансированы (например, текущий месяц содержит 90% активности, а старый - 1%), оптимизатор может ошибиться в выборе индекса. Регулярно запускайте `ANALYZE TABLE`, чтобы обновить кардинальность индексов.
Альтернативы: шардирование vs секционирование
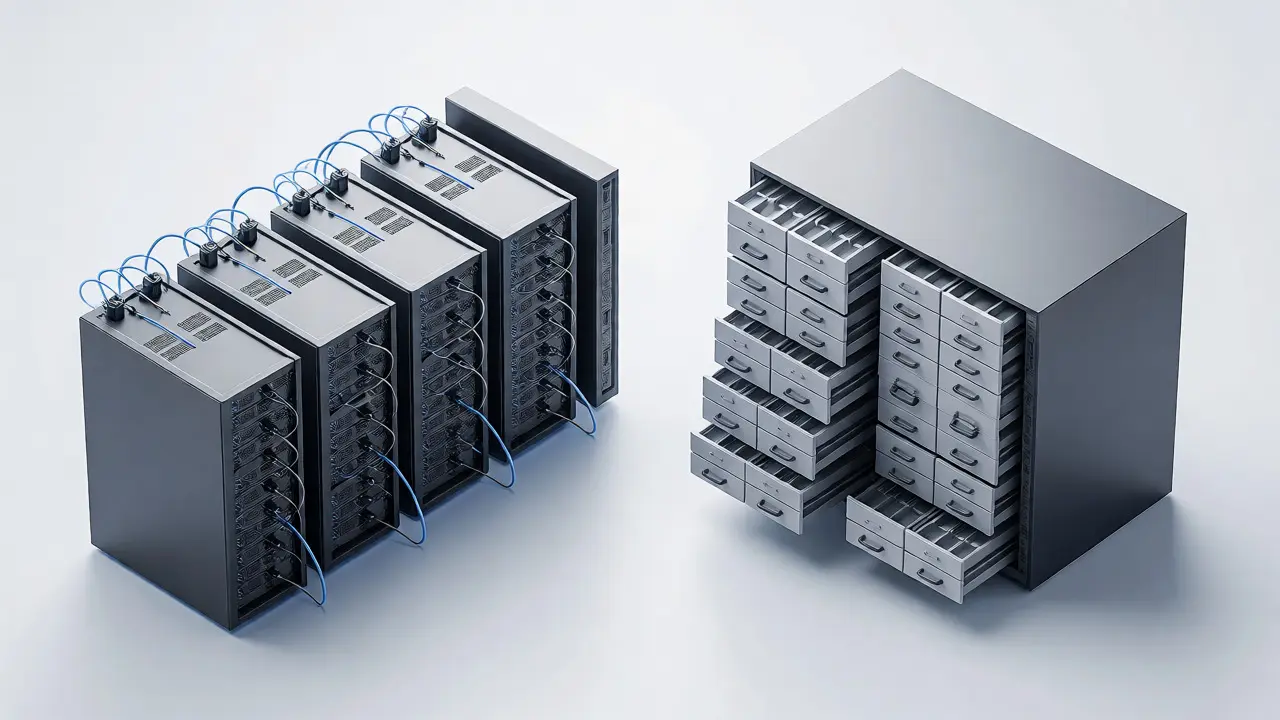
Не путайте секционирование с шардированием. Секционирование происходит внутри одного экземпляра MySQL. Все разделы находятся на одном сервере, используют один буферный пул и одни ресурсы CPU. Шардирование же распределяет данные по разным физическим серверам.
Если ваш узкий бутылочное горлышко - это CPU или RAM одного сервера, секционирование не поможет. Оно поможет, если проблема в размере индексов, скорости поиска по диапазону или необходимости быстро чистить старые данные. Для горизонтального масштабирования записи (write scaling) вам потребуется шардирование на уровне приложения или использование специализированных решений вроде Vitess или ProxySQL.
Секционирование - это инструмент вертикальной организации данных. Он делает вашу базу данных аккуратнее и быстрее для определенных типов нагрузок, но не заменяет необходимость правильного индексирования и нормализации. Используйте его точечно: для больших журнальных таблиц, логов, исторических данных. Для маленьких справочников или таблиц с частыми обновлениями произвольных строк оно скорее создаст головную боль, чем принесет пользу.
Можно ли секционировать таблицу с внешними ключами?
Нет, MySQL не поддерживает внешние ключи (FOREIGN KEY) для секционированных таблиц. Если таблица имеет FK, указывающий на нее, или сама ссылается на другую таблицу через FK, секционирование невозможно. Целостность данных в таких случаях должна обеспечиваться на уровне приложения.
Как влияет секционирование на скорость INSERT?
На скорость вставки влияние минимально, если ключ секционирования выбран правильно. Однако, если вы используете HASH-секционирование, каждая вставка требует расчета хеша и определения целевого раздела, что добавляет незначительные накладные расходы. RANGE-секционирование обычно быстрее для вставок, так как новые данные всегда идут в последний раздел.
Что делать, если нужно удалить данные из середины истории?
Удаление отдельных строк из произвольного раздела работает так же, как в обычной таблице, но медленнее из-за необходимости искать нужный раздел. Массовое удаление строк из старого раздела лучше выполнять через команду `ALTER TABLE ... DROP PARTITION`, если удаляются все данные раздела. Для частичного удаления используйте обычный DELETE, но учитывайте фрагментацию индексов.
Поддерживает ли MySQL автоматическое создание разделов?
Нет, MySQL не создает новые разделы автоматически при переполнении текущего диапазона. Вам нужно самостоятельно управлять этим процессом через события EVENT Scheduler или внешний скрипт (cron), который периодически выполняет `ALTER TABLE ... ADD PARTITION`.
Как проверить, какие разделы используются запросом?
Используйте команду `EXPLAIN SELECT ...`. В колонке `partitions` будет указан список разделов, которые сервер планирует прочитать. Если там написано `ALL` или перечислены все разделы, значит, механизм отсечения разделов (partition pruning) не сработал, и оптимизация неэффективна.