
On-device ИИ в мобильных приложениях: Core ML и нейросети на устройстве
 ноя, 8 2026
Помните, как раньше любое умное приложение требовало стабильного интернета? Вы фотографировали блюдо, ждали загрузки модели распознавания, а если ловили сеть только на одном делении - всё, провал. Сегодня ситуация изменилась радикально. On-device AI (искусственный интеллект на устройстве) превратил ваш смартфон в локальную вычислительную машину, способную обрабатывать данные мгновенно и без отправки их на сервер. Это не просто удобство - это приватность, скорость и независимость от качества связи.
Если вы разработчик или продуктовый менеджер, вам нужно понимать, как внедрять эти технологии правильно. Разберемся, почему Core ML стал стандартом де-факто для iOS, какие есть альтернативы для Android и когда вообще стоит уходить с облака на устройство.
Зачем переносить ИИ с сервера на телефон?
Первый вопрос, который возникает при обсуждении on-device моделей: «Зачем усложнять жизнь себе и пользователю?» Ответ кроется в трех ключевых проблемах облачных решений: задержке, стоимости и конфиденциальности.
Задержка (Latency). Даже при идеальном соединении запрос к серверу занимает время. Для чата это терпимо, но для дополненной реальности или фильтра камеры каждая миллисекунда критична. Локальная обработка убирает сетевой пинг полностью. Модель запускается за доли секунды прямо в памяти телефона.
Конфиденциальность. Отправлять фото лица, голосовые сообщения или медицинские показатели на внешний сервер - риск. Пользователи все чаще требуют, чтобы данные оставались на их гаджете. On-device AI решает эту проблему кардинально: данные не покидают устройство, поэтому их нельзя перехватить или случайно утечь из базы данных компании.
Стоимость инфраструктуры. Обработка миллионов изображений через AWS Lambda или Google Cloud Vision стоит денег каждый раз, когда пользователь открывает приложение. Если модель работает локально, ваши расходы на сервера падают почти до нуля после этапа разработки. Единственная цена - немного увеличенный размер APK/IPA файла.
Core ML: сердце экосистемы Apple
Для разработчиков под iOS ситуация максимально прозрачна благодаря фреймворку Core ML. Это нативный инструмент от Apple, который позволяет интегрировать обученные модели машинного обучения напрямую в Swift-код. Но магия начинается не в коде, а в аппаратной части.
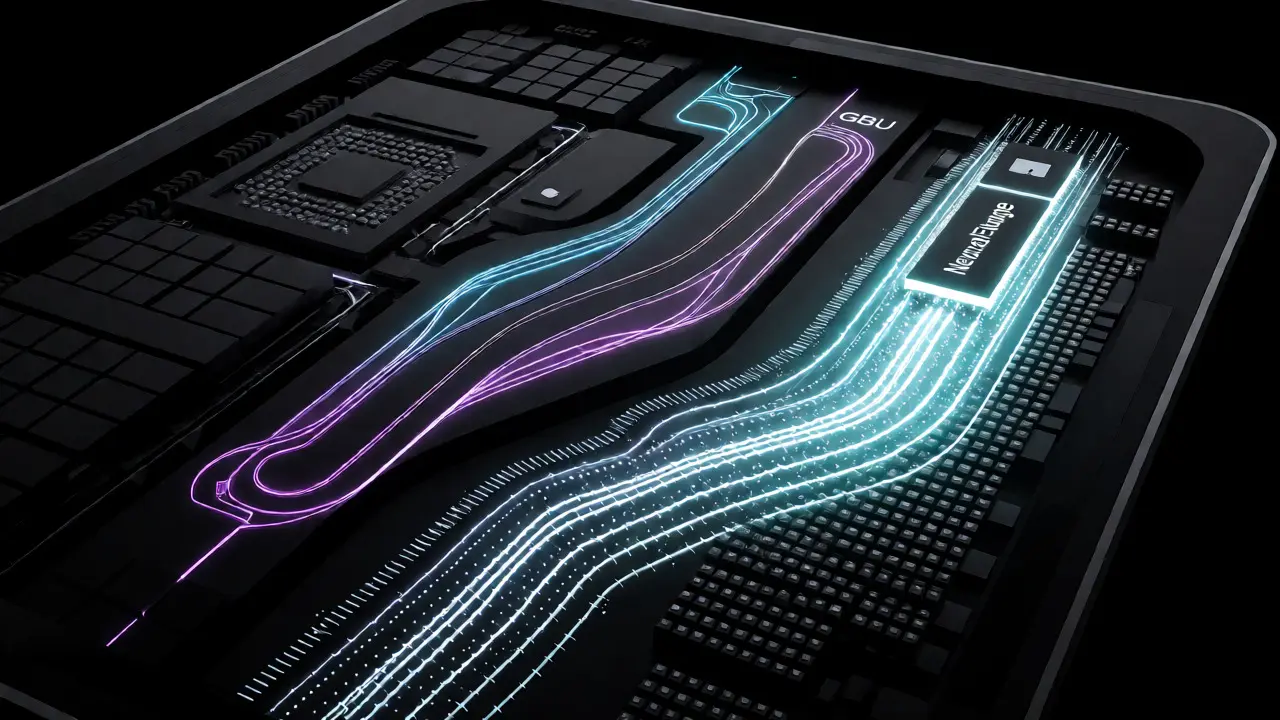
Apple спроектировала свои процессоры A-series и M-series так, чтобы они идеально подходили для задач ИИ. Здесь работают три блока:
- CPU - для общей логики и предобработки данных.
- GPU - для параллельных вычислений, например, при работе с изображениями.
- Neural Engine (NPU) - специализированный нейропроцессор, созданный исключительно для операций матричного умножения.
Когда вы используете Core ML, система автоматически выбирает оптимальный блок для каждого слоя нейросети. В последних моделях iPhone Neural Engine способен выполнять триллионы операций в секунду (TOPS). Это значит, что сложные задачи, такие как сегментация изображения в реальном времени или распознавание речи, выполняются быстрее, чем вы успеваете моргнуть.
| Блок процессора | Основная задача | Энергоэффективность | Пример использования |
|---|---|---|---|
| CPU | Логика, условные операторы | Низкая для тяжелых задач | Подготовка данных перед подачей в модель |
| GPU | Графика, большие матрицы | Средняя | Фильтры для камеры, стилизация |
| Neural Engine | Инференс нейросетей | Максимальная | Face ID, Siri, Live Text |
Как подготовить модель: путь от Python к Swift
Вы не можете просто взять файл модели из TensorFlow или PyTorch и бросить его в Xcode. Нужно конвертировать формат. Здесь на помощь приходит инструмент Core ML Tools. Это библиотека на Python, которая переводит веса и структуру сети в оптимизированный формат .mlmodel или .mlpackage.
Процесс выглядит так:
- Обучите модель на десктопе (где мощные видеокарты).
- Используйте coremltools.convert() для перевода в формат Apple.
- Оптимизируйте модель: примените квантование (quantization), чтобы уменьшить размер весов с float32 до int8 или float16.
- Добавьте метаданные: имена входных и выходных параметров, описание модели.
- Импортируйте файл в проект Xcode. Автоматически генерируется класс Swift, который можно вызывать напрямую.
Квантование - важный этап. Полноточная модель может занимать 500 МБ и греть телефон. Квантованная версия того же алгоритма займет 125 МБ и будет работать холоднее, потеряв в точности всего пару процентов. Для большинства потребительских приложений это приемлемая плата.
Альтернативы для Android и кроссплатформенности
Если ваша аудитория смешанная, полагаться только на Core ML нельзя. На Android исторически царил хаос из разных форматов, но сейчас стандарт - TensorFlow Lite (сейчас переименован в TFLite / LiteRT). Он легковесен, поддерживает кастомные операции и хорошо дружит с GPU Delegate и NNAPI (Neural Networks API).
Есть и универсальные решения:
- ONNX Runtime: открытая среда выполнения, которая позволяет один раз экспортировать модель в формат ONNX и запускать ее на любом железе - от Windows до Raspberry Pi.
- Paddle Lite: популярное решение от Baidu, особенно сильное в задачах компьютерного зрения.
Однако кроссплатформенность имеет цену. Вы теряете доступ к глубокой интеграции с операционной системой. Например, Core ML умеет использовать Metal Performance Shaders (MPS) для ускорения градиентов, чего нет в стандартном TFLite без дополнительных настроек. Если ваше приложение требует максимальной скорости на iPhone, пишите под Core ML. Если важна поддержка тысяч дешевых Android-смартфонов - смотрите в сторону ONNX или TFLite.
Практические кейсы: где это уже работает
Теория хороша, но давайте посмотрим, как это выглядит в реальных продуктах. Мы в Ростове часто видим примеры удачного внедрения в локальных стартапах.
Приложения для здоровья. Приложения для подсчета калорий используют камеры для распознавания еды. Отправка фото каждого яблока в облако была бы дорогой ошибкой. Локальные модели YOLOv8 или MobileNet распознают продукты за 0.2 секунды, сохраняя историю питания пользователя приватной.
Навигация и AR. Приложения вроде IKEA Place или навигаторы с дополненной реальностью должны рисовать объекты поверх реального мира без лагов. Если бы данные о геометрии комнаты отправлялись на сервер, вы бы видели «прыгающие» предметы. On-device SLAM (одновременная локализация и построение карты) делает это плавно.
Голосовые помощники. Siri и Alexa частично перешли на локальную обработку команд. Фразы типа «Включи музыку» или «Установи таймер» распознаются на устройстве. Только сложные запросы («Какая погода будет завтра в Сочи?») уходят в облако. Это экономит батарею и ускоряет реакцию ассистента.
Подводные камни и оптимизация
Не все модели подходят для мобильных устройств. Большие трансформеры (как в ChatGPT) занимают гигабайты памяти и требуют мощных серверов. Запустить LLM на телефоне сложно, хотя квантованные версии вроде Phi-3 или Gemma Nano уже начинают появляться.
Главные риски:
- Размер приложения. Каждая модель добавляет мегабайты к дистрибутиву. Если вы добавите пять разных моделей, размер скачивания вырастет, что может снизить конверсию установки.
- Нагрев устройства. Постоянная работа Neural Engine потребляет энергию. Если приложение фоново анализирует микрофон 24/7, батарея сядет быстро.
- Версионирование. Обновление модели сложнее, чем обновление кода. Вам нужно управлять версией модели внутри приложения, чтобы старые клиенты не ломались при изменении формата входа/выхода.
Совет: используйте динамическую загрузку моделей. Не тащите все веса сразу при первом запуске. Скачивайте нужную модель в фоне, когда пользователь подключен к Wi-Fi и заряжает телефон. Apple предоставляет для этого механизм Background Assets.
Будущее: гибридные архитектуры
Чистый on-device или чистое облако - это крайности. Будущее за гибридным подходом. Простые задачи решаются локально за миллисекунды. Сложные, требующие огромных знаний или свежих данных, уходят в облако. Приложение само решает, куда направить запрос, исходя из текущей ситуации с сетью и зарядом батареи.
Технологии развиваются стремительно. Apple анонсировала Apple Intelligence, где часть обработки проходит на устройстве, а часть - на защищенных серверах Private Cloud Compute. Это новый уровень безопасности, который скоро станет стандартом ожидания пользователей.
Что такое Core ML простыми словами?
Core ML - это фреймворк от Apple, который позволяет запускать обученные модели искусственного интеллекта прямо на iPhone, iPad или Mac. Он автоматически распределяет вычисления между процессором, графикой и нейропроцессором (Neural Engine) для максимальной скорости и экономии энергии.
Нужен ли интернет для работы on-device ИИ?
Нет, главная фишка on-device моделей в том, что они работают офлайн. После того как приложение скачано и модель загружена, она функционирует независимо от наличия сети. Интернет нужен только для обновления самой модели или получения новых данных извне.
Как влияет размер модели на производительность?
Чем меньше модель, тем быстрее она загружается в память и тем меньше энергии тратит на inference. Однако слишком маленькая модель может потерять в точности. Баланс достигается через квантование (уменьшение точности чисел) и прунинг (удаление лишних связей в нейросети).
Можно ли использовать модели TensorFlow на iOS?
Да, но не напрямую. Сначала модель TensorFlow нужно конвертировать в формат Core ML с помощью библиотеки coremltools. После конвертации она становится родной для iOS и может использовать все преимущества железа Apple.
Какие модели лучше всего подходят для мобильных устройств?
Для мобильных задач оптимизированы архитектуры класса MobileNet, EfficientNet и SqueezeNet. Они специально разработаны с учетом ограниченных ресурсов смартфонов, предлагая хороший баланс между скоростью и качеством распознавания.