
Мультитенантность в бэкенде: стратегии изоляции данных клиентов
 сен, 26 2026
Представьте ситуацию: вы запускаете SaaS-платформу, и на старте у вас три клиента. Всё летает, база данных маленькая, запросы мгновенные. Проходит год, клиентов становится триста, а один из них начинает жаловаться на тормоза. Вы открываете логи и видите, что их тяжелый отчет блокирует таблицу, которую одновременно читает другой клиент. Знакомая боль? Это классический пример того, как экономия на инфраструктуре оборачивается проблемами с производительностью и безопасностью.
Мультитенантность - это не просто модное слово из презентаций для инвесторов. Это архитектурный подход, при котором одно приложение обслуживает множество клиентов (тенантов), разделяя между ними ресурсы сервера и базы данных. Звучит эффективно, правда? Один код, одна команда поддержки, единая точка обновления. Но есть подвох: если вы неправильно настроите изоляцию данных, то утечка информации от одного клиента к другому станет вопросом времени, а не вероятности.
Почему мультитенантность пугает новичков
Когда разработчик впервые сталкивается с необходимостью строить многопользовательскую систему, соблазн прост: сделать одну большую базу данных, добавить колонку `tenant_id` во все таблицы и забыть о проблемах. Для MVP (минимально жизнеспособного продукта) это отличный ход. Быстро, дешево, сердито. Но как только вы выходите на уровень enterprise или начинаете работать с чувствительными данными (финансы, медицина, персональные данные по GDPR), такая модель начинает трещать по швам.
Главная ошибка здесь - путать логическую изоляцию с физической. Логическая изоляция работает на уровне приложения: ваш код проверяет, кому принадлежит запись, прежде чем отдать её пользователю. Физическая изоляция гарантирует, что данные физически лежат в разных местах или недоступны друг другу даже при ошибке в коде. В реальном мире баги случаются. Если вы забыли поставить фильтр `WHERE tenant_id = ?` в одном из тысяч SQL-запросов, вы можете показать счета компании «Ромашка» конкуренту «Лютик». И нет, извинениями тут не отделаешься.
Три уровня изоляции: от простой к сложной
Давайте разберем основные подходы к организации хранения данных. Каждый имеет свои плюсы и минусы, и выбор зависит от вашего бюджета, требований безопасности и ожидаемой нагрузки.
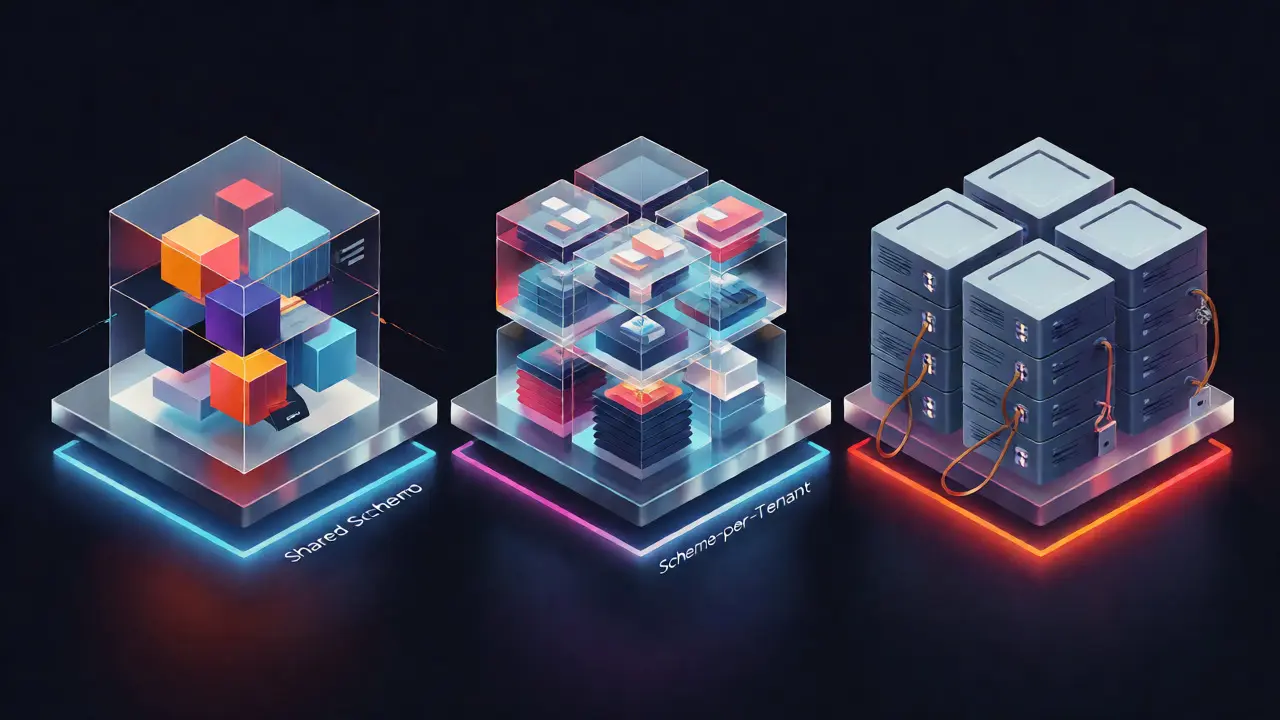
1. Общая схема с ключом тенанта (Shared Schema)
Это самый распространенный вариант для стартапов. Все данные всех клиентов лежат в одних и тех же таблицах, но каждая строка помечена идентификатором клиента.
| Характеристика | Общая схема (Shared Schema) | Отдельная схема (Schema-per-Tenant) | Отдельная БД (Database-per-Tenant) |
|---|---|---|---|
| Стоимость инфраструктуры | Низкая | Средняя | Высокая |
| Сложность миграций | Простая (один скрипт) | Средняя (цикл по схемам) | Сложная (цикл по базам) |
| Безопасность данных | Логическая (риск ошибок кода) | Физическая граница схемы | Максимальная |
| Производительность | Зависит от индексов | Стабильная | Стабильная, но выше нагрузка на сервер |
Преимущество очевидно: вам нужно управлять всего одной структурой базы данных. Обновить схему таблицы можно одним скриптом. Однако производительность падает линейно с ростом объема данных. Если у вас миллиард строк в таблице `orders`, поиск конкретного заказа может стать медленным, если индексы настроены плохо. Кроме того, существует риск "шумных соседей": если один крупный клиент запустит тяжелый аналитический запрос, он может заблокировать работу остальных.
2. Схема на тенанта (Schema-per-Tenant)
В этом варианте каждый клиент получает свою собственную схему внутри одной базы данных. Например, в PostgreSQL вы создаете схему `client_101`, `client_102` и так далее. Внутри каждой схемы своя структура таблиц.
Такой подход обеспечивает более высокую степень изоляции. Ошибка в запросе одного клиента редко влияет на другого, так как они работают с разными объектами. Миграции становятся сложнее: вместо одного скрипта вам нужно пройтись циклом по всем схемам и применить изменения в каждой. Если клиентов тысячи, этот процесс может занять часы, требуя умных инструментов автоматизации вроде Flyway или Liquibase.
3. База данных на тенанта (Database-per-Tenant)
Вершина изоляции. У каждого клиента своя физическая база данных. Это стандарт для крупных корпоративных решений, где требования к безопасности максимальны. Клиент может потребовать выделить ему отдельный сервер или даже физический диск.
Но расплата за это высока. Управление тысячами баз данных требует мощных инструментов оркестрации. Резервное копирование, восстановление, мониторинг - всё это нужно масштабировать автоматически. К тому же, если вы решите добавить новую функцию, требующую изменения структуры данных, вам придется обновлять каждую базу отдельно. Это идеально подходит для VIP-клиентов, которые платят дорого и требуют гарантий, но убивает экономику для малого бизнеса.
Как не потерять данные: практические советы
Независимо от выбранной архитектуры, есть несколько правил, которые спасут вашу репутацию.
- Контекст запроса обязателен. Никогда не полагайтесь на то, что пользователь передаст `tenant_id` в параметрах URL. Этот ID должен определяться на уровне аутентификации (например, из JWT-токена) и внедряться в контекст выполнения запроса автоматически. В современных фреймворках вроде Django или Spring Boot это делается через middleware или интерцепторы.
- Row-Level Security (RLS). Современные СУБД умеют ограничивать доступ к строкам на уровне самой базы данных. В PostgreSQL вы можете настроить политику RLS так, что любой запрос без явного указания текущего пользователя просто не увидит чужие данные. Даже если программист ошибется и забудет фильтр в коде, база сама отсеет лишнее.
- Кэширование требует осторожности. Redis или Memcached - ваши лучшие друзья для скорости, но враги для безопасности, если вы забываете ключи. Всегда включайте `tenant_id` в ключ кэша. Иначе клиент А получит данные клиента Б из общего кэша. Простой пример: ключ должен быть `user:profile:101:456`, а не просто `user:profile:456`.
- Шардинг для роста. Когда количество клиентов перевалит за десятки тысяч, одна база данных перестанет справляться. Здесь на помощь приходит шардинг - горизонтальное разбиение данных. Можно распределять клиентов по разным серверам баз данных динамически. Важно заранее продумать стратегию балансировки нагрузки, чтобы новые клиенты попадали на менее загруженные узлы.
Инструменты и технологии
Чтобы реализовать мультитенантность без боли, стоит использовать проверенные решения. Не пытайтесь писать свой роутинг соединений с нуля, если есть готовые библиотеки.
Для Python-разработчиков популярен пакет django-multitenant. Он позволяет прозрачно переключать схемы в зависимости от домена или субдомена пользователя. В экосистеме Java часто используют Hibernate с фильтрами или специализированные модули от производителей СУБД. Node.js разработчики могут обратить внимание на Prisma или TypeORM, которые поддерживают сложные конфигурации подключений.
Не забывайте про мониторинг. Инструменты вроде Prometheus и Grafana должны показывать нагрузку не только на сервер в целом, но и на каждого отдельного тенанта. Если вы видите, что один клиент потребляет 80% ресурсов CPU, пора задуматься о его переводе на выделенную инфраструктуру или оптимизации его запросов.
Когда менять стратегию?
Архитектура должна эволюционировать вместе с бизнесом. Начните с общей схемы, пока клиентов меньше ста. Как только начнете замечать проблемы с производительностью или получите первых крупных заказчиков с требованиями к безопасности, переходите на схемы или отдельные базы для этих VIP-клиентов. Гибридная модель, где малые бизнесы живут в общей базе, а крупные имеют свои схемы, часто оказывается самым выгодным компромиссом.
Помните: мультитенантность - это не разовое решение, а непрерывный процесс балансировки между стоимостью эксплуатации и качеством сервиса. Ошибки здесь стоят дорого, поэтому лучше потратить время на проектирование сейчас, чем тушить пожары потом.
Что такое "шумный сосед" в контексте мультитенантности?
Это ситуация, когда один клиент потребляет непропорционально большое количество ресурсов (CPU, память, ввод-вывод дисков), что негативно сказывается на производительности других клиентов, использующих те же ресурсы. Решается ограничением ресурсов (cgroups, quotas) или выделением отдельной инфраструктуры для таких клиентов.
Можно ли мигрировать с общей схемы на схему-на-тенанта без даунтайма?
Полностью без даунтайма сложно, но возможно с использованием двойной записи (dual-write). Сначала данные пишутся в обе структуры, затем происходит сверка, и наконец чтение переводится на новую структуру. Процесс требует тщательного тестирования и может занять недели для больших объемов данных.
Как обеспечить безопасность данных при использовании Row-Level Security (RLS)?
RLS работает на уровне СУБД. Необходимо создать политики доступа, которые разрешают просмотр строк только если значение колонки tenant_id совпадает с текущим идентификатором пользователя, установленным в сессии соединения. Важно убедиться, что приложение корректно устанавливает эту переменную сессии перед выполнением любого запроса.
Какой метод изоляции выбрать для стартапа с ограниченным бюджетом?
Для большинства стартапов оптимальным выбором является общая схема (Shared Schema) с жестким контролем на уровне ORM и обязательным использованием индексов по tenant_id. Это минимизирует затраты на инфраструктуру и администрирование, позволяя сосредоточиться на развитии продукта.
Как обрабатывать резервное копирование в модели Database-per-Tenant?
Автоматизация критична. Используйте скрипты, которые обходят все базы данных и выполняют дампы (например, pg_dump для PostgreSQL) параллельно или последовательно в зависимости от ресурсов сервера. Храните бэкапы с метаданными о тенанте, чтобы иметь возможность восстановить конкретную базу быстро.