
dbt в аналитике: как превратить SQL-запросы в управляемый код
 окт, 11 2026
Знаете это чувство, когда вы открываете Excel или BI-дашборд, видите красивую цифру выручки за прошлый квартал, но внутри всё сжимается от страха? А вдруг кто-то случайно изменил формулу в ячейке на листе "Черновик_2019"? Или аналитик Вася забыл обновить скрипт в Airflow, и данные за вчера просто не досчитались двух миллионов рублей из-за дубликата транзакции?
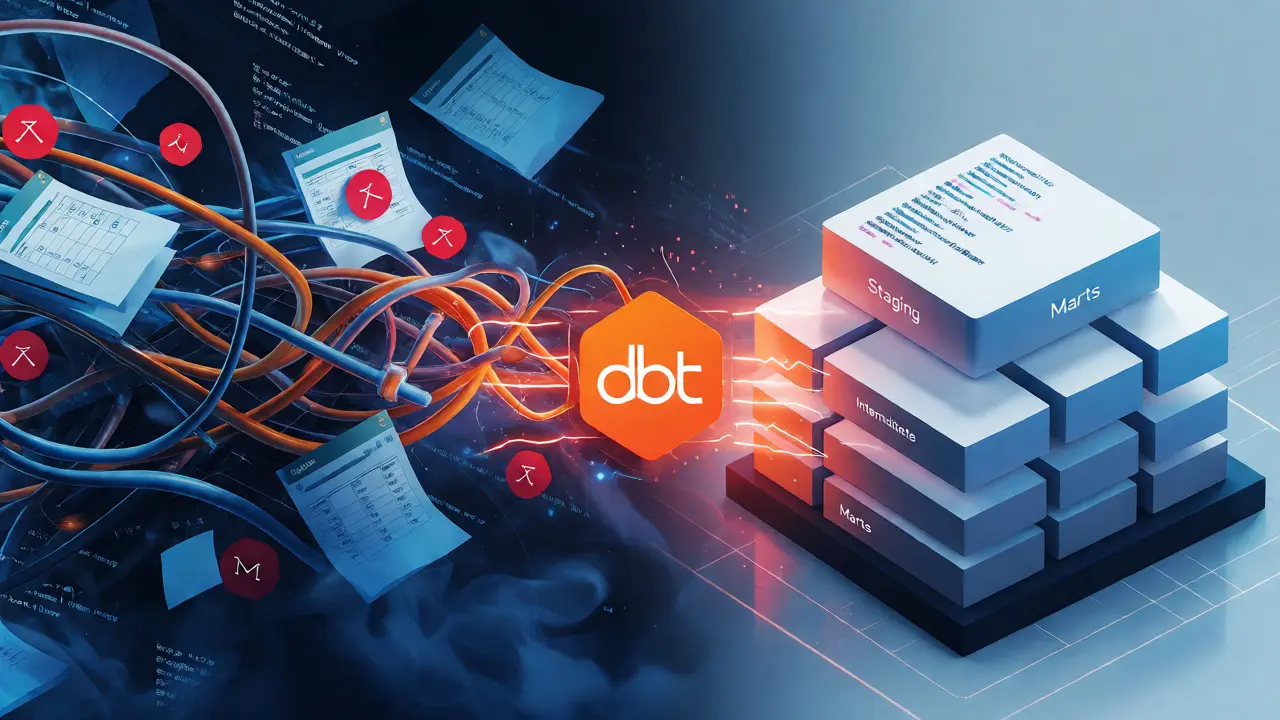
Классическая аналитика часто похожа на жонглирование горящими углями. Данные приходят сырыми, их нужно чистить, склеивать, агрегировать. И обычно это делается где угодно: в ручных запросах, в Python-ноутбуках, которые никто не может запустить без магии, или в бесконечных хранимых процедурах внутри базы данных. Результат - хаос, где невозможно понять, откуда взялась конкретная метрика.
Здесь на сцену выходит dbt (data build tool). Это инструмент для трансформации данных, который позволяет писать SQL так, будто вы разрабатываете обычное программное обеспечение. Никаких сложных IDE, никаких компиляций C++. Просто SQL, Git и здравый смысл. Если вы устали от того, что ваша аналитическая инфраструктура напоминает лоскутное одеяло, dbt может стать тем клеем, который скрепит всё вместе.
Что такое dbt и почему он меняет правила игры
Давайте сразу к сути. dbt - это инструмент с открытым исходным кодом, который работает поверх вашего существующего хранилища данных (Snowflake, BigQuery, Redshift, Postgres). Он не перемещает данные и не хранит их сам. Его задача - брать сырые таблицы (raw data), применять к ним логику преобразования через SQL-запросы и создавать новые, готовые к использованию таблицы или представления (views).
Главная фишка dbt в том, что он превращает SQL в модульный код. Вы можете импортировать части запросов, использовать переменные, циклы и условные операторы прямо внутри SQL-файлов. Но самое важное - каждая модель (таблица) становится объектом контроля версий. Вы коммитите изменения в Git, делаете Pull Request, проходите Code Review. Да, ваш SQL теперь проходит ревью, как код бэкендера. Это радикально повышает доверие к данным.
Представьте типичную ситуацию без dbt: у вас есть таблица `orders_raw`. Чтобы получить ежедневную выручку, вы пишете сложный JOIN с таблицей `users` и фильтрацию по статусам. Этот запрос лежит в голове аналитика или в одном файле .sql. Через месяц приходит новый сотрудник и спрашивает: "А почему мы считаем только статус 'paid'?". Ответ потерян в истории переписок. С dbt этот запрос оформлен как отдельный файл `daily_revenue.sql`, имеет описание, теги и ссылки на родительские модели. Документация генерируется автоматически.
Архитектура данных: от ELT к управляемым трансформациям
Чтобы понять место dbt, нужно вспомнить эволюцию пайплайнов данных. Раньше правили бал ETL (Extract, Transform, Load). Данные вытаскивали, трансформировали на промежуточном сервере и загружали в хранилище. Это было медленно и дорого.
С появлением облачных хранилищ вроде Snowflake или BigQuery, мир перешел к ELT (Extract, Load, Transform). Сначала грузим всё сырым в хранилище, а потом крутим данными там, где мощности хватает на всех. Трансформация происходит внутри хранилища.
Но здесь возникает проблема масштабируемости. Когда у вас 50 таблиц и 200 зависимостей между ними, ручное управление порядком выполнения запросов превращается в ад. Кто первый должен выполниться? Что делать, если источник упал? Нужно ли пересчитывать все downstream-таблицы?
dbt решает эту задачу, строя граф зависимостей (DAG - Directed Acyclic Graph). Вы описываете связи между моделями с помощью функции `ref()`. Например:
{{ ref('stg_orders') }}Эта строчка говорит dbt: "Эта модель зависит от модели stg_orders". Инструмент сам понимает порядок исполнения. Если вы измените `stg_orders`, dbt знает, какие таблицы нужно пересчитать следом. Вам не нужно вручную настраивать триггеры в Airflow для каждой зависимости. Достаточно один раз настроить оркестрацию запуска самого dbt.
Структура проекта: как организовать код
Новички часто путаются в структуре папок dbt. Давайте разберем её на примере реального интернет-магазина. Проект dbt состоит из нескольких ключевых директорий:
- models: Сердце проекта. Здесь лежат ваши SQL-файлы с трансформациями.
- sources: Описание сырых данных из внешних систем (CRM, ERP, логов).
- tests: Проверки качества данных (непустые поля, уникальность ID).
- macros: Переиспользуемые фрагменты кода, аналог функций в программировании.
- seeds: Небольшие справочники, которые удобно хранить в CSV и загружать в БД.
Внутри папки `models` принято использовать слоистую архитектуру (Layered Architecture). Это стандарт де-факто в современной инженерии данных.
| Слой | Название моделей | Цель | Пример содержимого |
|---|---|---|---|
| Staging | `stg_*` | Очистка и стандартизация сырых данных | Переименование колонок, приведение типов, удаление дублей |
| Intermediate | `int_*` | Логические блоки для повторного использования | Объединение заказов с пользователями, расчет LTV |
| Marts | `mrt_*` или `fct_*` | Финальные витрины для аналитиков | Таблица продаж по дням, когорты пользователей |
Почему это важно? Без слоев вы получите спагетти-код, где одна таблица зависит от десяти других, а те зависят от первой. Слоистая структура делает код читаемым. Аналитик смотрит только на слой Marts. Инженер данных правит Staging, если прилетели грязные данные из API. Intermediate слой служит буфером, чтобы не менять логику источников каждый раз.
Инкрементальная обработка: экономия денег и времени
Если у вас таблица с историей транзакций за 5 лет, пересчитывать её целиком каждый день - расточительство. В Snowflake это стоит реальных денег. Для больших объемов данных используют инкрементальные модели.
В dbt это делается одной директивой в начале файла:
{{ config(materialized='incremental', unique_key='order_id') }}При первом запуске таблица создается полностью. При последующих запусках dbt выполняет запрос только для новых строк (например, где дата больше максимальной даты в целевой таблице) и вставляет их. Это ускоряет пайплайн в десятки раз и снижает нагрузку на хранилище.
Но будьте осторожны. Инкрементальные модели сложнее отлаживать. Если вы ошиблись в условии фильтрации новых данных, старые записи могут остаться неверными навсегда. Поэтому всегда пишите тесты для таких моделей.
Тестирование данных: автоматизация качества
Вы когда-нибудь обнаруживали ошибку в отчете только после того, как шеф спросил: "А почему выручка упала на 30%?", а вы потратили полдня на поиск причины? В dbt качество данных проверяется автоматически перед публикацией результатов.
Инструмент предоставляет встроенные тесты:
unique: Проверяет, что значения в колонке уникальны (идеально для первичных ключей).not_null: Убеждается, что в поле нет пустых значений.accepted_values: Проверяет, что данные попадают в список разрешенных (например, статус заказа только 'new', 'paid', 'cancelled').
Но настоящая сила - в кастомных тестах. Допустим, сумма позиций в заказе должна равняться итоговой сумме заказа. Вы пишете SQL-запрос, который возвращает строки с ошибками. Если запрос вернул хоть одну строку, тест падает, и пайплайн останавливается. Плохие данные не попадут в дашборды.
Это меняет культуру работы с данными. Вместо тушения пожаров постфактум, вы предотвращаете их заранее. Тесты становятся частью документации. Читая файл `schema.yml`, можно точно понять бизнес-правила, заложенные в данные.
Документация и Lineage: карта ваших данных
Одна из самых недооцененных фич dbt - автогенерируемая документация. Команда `dbt docs generate` собирает все комментарии из ваших SQL-файлов, описания из YAML-файлов и метаданные из базы данных в интерактивный веб-сайт.
Что там полезного?
- Lineage Graph: Визуализация связей между таблицами. Вы кликаете на метрику "Чистая прибыль" и видите цепочку: она берется из `mrt_financials`, которая зависит от `int_costs` и `stg_invoices`. Если источник сломался, вы сразу видите, какие отчеты затронуты.
- Column Descriptions: Каждое поле имеет описание. Больше не нужно гадать, что означает аббревиатура `is_active_flag_v2`.
- Source Freshness: Можно настроить проверку актуальности источников. Если данные из CRM не обновлялись более 24 часов, dbt предупредит об этом.
Для команды из 5+ человек такая документация критически важна. Она снижает порог входа для новых сотрудников. Им не нужно неделю ходить по офису и спрашивать: "А где лежит таблица с клиентами?". Они просто открывают локальный сайт документации.
Когда dbt не нужен (или еще рано)
Не стоит внедрять dbt везде подряд. Это не серебряная пуля.
Если у вас стартап с тремя таблицами и одним аналитиком, который пишет запросы в Metabase напрямую к базе, dbt может стать лишним бюрократическим слоем. Настройка CI/CD, настройка окружений (dev/prod), обучение команды - всё это требует времени.
Также dbt плохо подходит для сложной потоковой обработки (streaming) или машинного обучения, где нужны специфические библиотеки Python/R. Хотя экосистема растет, и есть интеграции с Airflow, Prefect и даже Spark, классический dbt - это батч-обработка SQL.
Но как только количество таблиц превышает 10-15, а количество запросов начинает мешать друг другу, боль от отсутствия структурированной трансформации растет экспоненциально. Именно тогда dbt окупается.
Практические советы по внедрению
Если вы решили попробовать, вот несколько рекомендаций, основанных на опыте коллег из разных компаний:
- Начните с малого. Не пытайтесь мигрировать весь DWH за один спринт. Возьмите одну проблемную область, например, финансовую отчетность, и переведите её на dbt.
- Разделяйте среды. Обязательно используйте профили подключения (`profiles.yml`). Разработчики должны работать в схеме `dev_username`, а продакшн-джобы - в схеме `analytics_prod`. Никогда не тестируйте новые модели прямо в проде.
- Пишите комментарии. SQL сам по себе читается тяжело. Оставляйте комментарии в стиле JSDoc или просто человеческие заметки над блоками кода. Через полгода вы себя поблагодарите.
- Используйте Jinja-шаблоны умеренно. dbt использует шаблонизатор Jinja2. Легко увлечься и написать такой мета-код, который будет сложнее читать, чем обычный SQL. Правило простое: если кусок повторяется дважды - выносите его в макрос. Если он слишком сложный - лучше оставить явный SQL.
Будущее аналитики: Data Contracts и Semantic Layer
Рынок инструментов для данных движется быстро. Сейчас активно развиваются концепции Data Contracts. Идея в том, что производитель данных (backend-разработчик) гарантирует структуру выходных данных, а потребитель (аналитик) опирается на эти гарантии. dbt уже поддерживает механизмы проверки схем, которые близки к этой идее.
Еще одно направление - семантический слой. Инструменты вроде Cube.dev или LookML пытаются убрать дублирование логики расчета метрик. Пока dbt отвечает за подготовку данных, семантические слои берут на себя определение метрик (как считать конверсию). Эти технологии не конкурируют, а дополняют друг друга.
dbt продолжает развиваться. Появляются dbt Cloud, dbt Core версии 1.x, поддержка новых баз данных. Но фундаментальный принцип остается неизменным: данные должны быть продуктом, а побочным эффектом IT-инфраструктуры.
Нужно ли знать Python для работы с dbt?
Нет, основной язык написания трансформаций в dbt - это SQL. Однако базовое понимание Python полезно для написания кастомных тестов или макросов, а также для взаимодействия с экосистемой (например, запуск через Airflow). Но начать можно, владея только SQL.
Можно ли использовать dbt с локальной базой данных PostgreSQL?
Да, dbt отлично работает с локальным PostgreSQL. Это популярный вариант для обучения и прототипирования. Вы можете установить dbt-core и драйвер dbt-postgres, создать проект и запускать модели против своей локальной базы без облачных затрат.
Как dbt справляется с изменяющейся схемой источника данных?
По умолчанию dbt может упасть, если в источнике исчезнет ожидаемая колонка. Однако есть конфигурации `on_schema_change`, которые позволяют игнорировать изменения, добавлять новые колонки или синхронизировать схему. Также используются тесты freshness и schema tests для мониторинга этих изменений.
В чем разница между dbt Core и dbt Cloud?
dbt Core - это open-source CLI-инструмент, который вы устанавливаете и запускаете сами (или через CI/CD). dbt Cloud - это SaaS-платформа, которая предоставляет интерфейс для редактирования кода, планировщик задач, управление секретами и расширенную документацию. Многие начинают с Core и переходят на Cloud для удобства управления командой.
Подходит ли dbt для работы с большими данными (TB/PB)?
Да, dbt спроектирован для работы с современными облачными хранилищами (Snowflake, BigQuery, Redshift), которые рассчитаны на терабайтные и петабайтные объемы. Производительность зависит от возможностей самой базы данных, так как dbt лишь отправляет SQL-запросы. Для оптимальной работы необходимо правильно настраивать партиционирование и инкрементальные загрузки.