
Data governance: как настроить политики доступа и пройти аудит
 сен, 21 2026
Знаете это чувство, когда аналитик спрашивает: «Где мне взять данные о продажах за прошлый квартал?», а вы понимаете, что в базе их три копии, одна устарела, вторая содержит дубликаты, а третья вообще не защищена паролем? Знакомо. В большинстве компаний проблема не в том, что данных мало, а в том, что никто не знает, кто имеет право к ним прикасаться и как эти данные должны выглядеть. Data governance - это система правил, процессов и ролей, которая превращает хаотичные наборы данных в надежный актив компании. Без нее любые попытки внедрить BI или ИИ заканчиваются тем, что руководство начинает сомневаться в цифрах на дашбордах.
Сегодня мы разберем, как построить эту систему так, чтобы она реально работала, а не лежала мертвым грузом в регламентах. Мы поговорим о том, как разделить права доступа, чтобы не душить бизнес бюрократией, и как подготовиться к проверкам регуляторов, не сходя с ума от бумажной волокиты.
Почему старые методы управления данными больше не работают
Раньше всё было просто: был администратор базы данных, он раздавал доступы «по знакомству» или по должностной инструкции. Сейчас объем данных растет экспоненциально. Если раньше компания хранила гигабайты отчетов, то сегодня речь идет о терабайтах логов, транзакций и пользовательских профилей. Когда каждый второй сотрудник может скачать выгрузку и сделать свой «эксель», теряется единая версия правды.
Представьте ситуацию из практики крупного ритейлера в Ростове-на-Дону. Отдел маркетинга считал конверсию по одной методике, финансы - по другой, а складские остатки вообще брались из старой ERP-системы. Итог: споры на совещаниях длились часами, потому что цифры не сходились. Это классический симптом отсутствия управления данными. Data governance решает эту проблему, устанавливая единые стандарты качества и определения метрик для всех подразделений.
Главная ошибка многих IT-директоров - попытка внедрить жесткую централизацию сразу. Они создают комитет из десяти человек, который должен согласовывать каждое изменение схемы БД. Результат предсказуем: бизнес обходит эти правила, создавая теневые хранилища данных (shadow IT). Поэтому подход должен быть гибким: управляйте критичными активами строго, а второстепенные - оставляйте на ответственность команд.
Политики доступа: баланс между безопасностью и скоростью
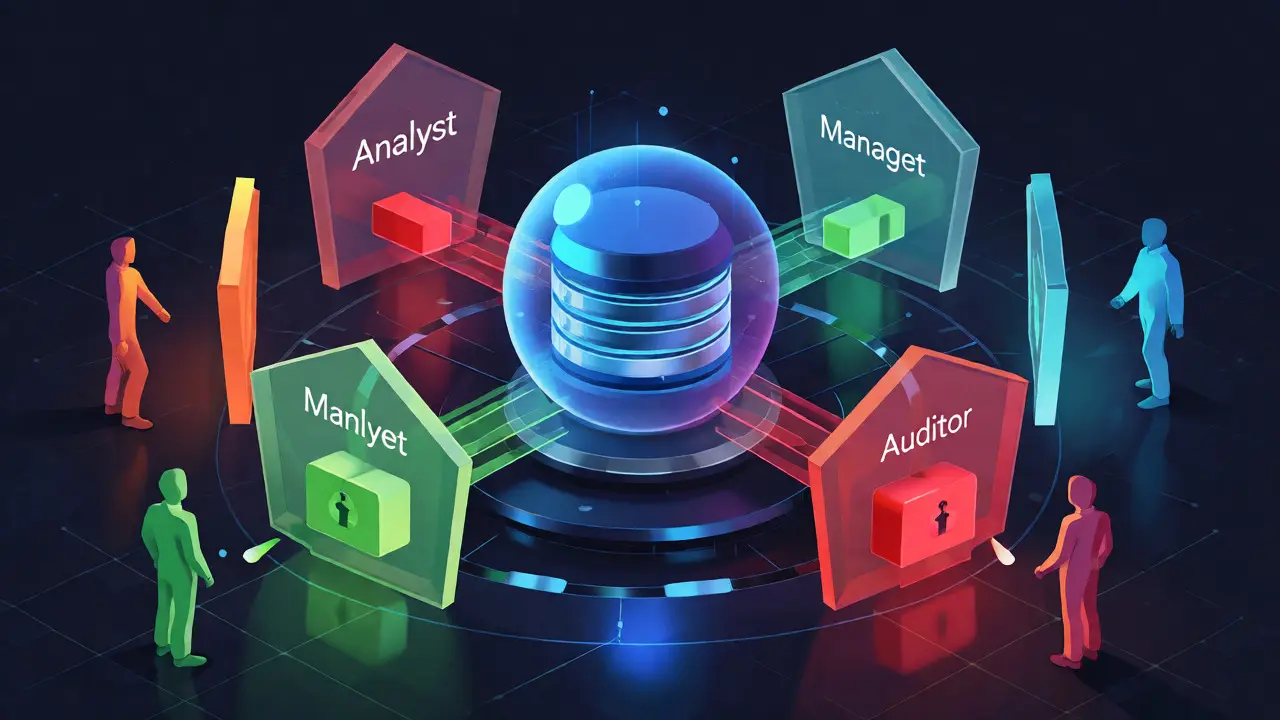
Ключевой элемент любой стратегии - это политики доступа, которые определяют, кто видит какие данные и при каких условиях. Здесь важно уйти от модели «все или ничего». Современный стандарт - это RBAC (Role-Based Access Control), где права назначаются не людям, а ролям.
Например, роль «Аналитик продаж» получает доступ к агрегированным данным о выручке, но не видит персональные контакты клиентов. Роль «Менеджер по работе с клиентами» видит контакты конкретного сегмента, но не имеет права выгружать всю базу в Excel. Такой подход снижает риски утечек и упрощает аудит: если сотрудник увольняется, вы просто удаляете его из роли, и все права автоматически аннулируются.
| Роль | Доступ к сырым данным | Доступ к агрегатам | Право на выгрузку | Обновление справочников |
|---|---|---|---|---|
| Data Engineer | Полный | Полный | Да | Да |
| Business Analyst | Ограниченный (читание) | Полный | Да (с лимитом) | Нет |
| Product Owner | Нет | Полный (свой продукт) | Нет | Нет |
| Compliance Officer | Полный (аудит) | Полный | Нет | Нет |
Но есть нюанс: статические роли часто ломаются при масштабировании. Что делать, если менеджер меняет регион работы? Или если проект требует временного доступа к чувствительным данным? Тут на помощь приходит ABAC (Attribute-Based Access Control). В этой модели решение о доступе принимается динамически на основе атрибутов пользователя (должность, отдел, уровень допуска) и данных (классификация конфиденциальности, время создания).
Практический совет: начните с классификации данных. Разделите информацию на четыре уровня:
- Открытые: можно читать всем сотрудникам и даже клиентам.
- Внутренние: доступны только штатным сотрудникам компании.
- Конфиденциальные: ограниченный круг лиц (например, финансовые показатели до публикации).
- Строго конфиденциальные: персональные данные, паспортные сведения, медицинские карты.
Соответствие требованиям: не только про штрафы
Многие воспринимают соответствие требованиям (compliance) как головную боль юристов. На самом деле, это фундамент доверия к данным. В России основным драйвером остается 152-ФЗ «О персональных данных», но также стоит учитывать отраслевые стандарты и требования ЦБ РФ для финтеха.
Что именно проверяют аудиторы?
- Локализация: Где физически хранятся серверы с ПДн? Для российских граждан они должны находиться на территории РФ.
- Цель обработки: Есть ли согласие пользователя на конкретное использование его данных? Нельзя собирать email для рассылки, а потом использовать его для скоринга без уведомления.
- Право на забвение: Можете ли вы технически удалить запись клиента из всех систем (основной БД, логов, резервных копий) по его запросу?
Частая ошибка - считать, что шифрование решает вопрос соответствия. Шифрование защищает данные при хранении, но не регулирует логический доступ. Если у менеджера есть пароль от базы, он сможет прочитать расшифрованные данные. Поэтому compliance требует связки технических мер (шифрование, маскирование) и организационных (регламенты, обучение сотрудников).
Возьмем пример с маскамированием данных. Аналитик хочет изучить поведение пользователей, ему нужны ID заказов и суммы, но фамилии и телефоны ему ни к чему. Вместо того чтобы выдавать ему полный доступ и рисковать утечкой PII (Personally Identifiable Information), используйте динамическое маскирование. Система подменяет реальные значения на псевдонимы или символы, сохраняя формат данных. Так аналитик получает возможность работать, а юристы спокойны.
Инструментарий: чем управлять этим хозяйством
Excel-таблица со списком доступов умрет через полгода после начала проекта. Вам нужны специализированные инструменты. Выбор зависит от стека технологий и бюджета.
- Apache Ranger: Популярное решение для экосистемы Hadoop. Позволяет централизованно управлять политиками доступа к Hive, HBase, Kafka и другим компонентам. Идеально для больших данных.
- Snowflake / BigQuery: Облачные хранилища уже имеют встроенные механизмы Row-Level Security (RLS) и Column-Level Security. Не нужно ставить сторонний софт, достаточно правильно настроить роли внутри СУБД.
- Collibra / Informatica: Тяжелая артиллерия для крупных корпораций. Эти платформы предлагают полный цикл: от каталога данных до автоматического применения политик безопасности. Дорого, мощно, но требует серьезной интеграции.
- Self-hosted решения (Amundsen, DataHub): Открытые метаданные-каталоги. Они позволяют видеть lineage (происхождение данных) и связывать таблицы с владельцами и политиками. Бесплатно, но требует инженерных ресурсов на поддержку.
Если вы только начинаете, не гонитесь за дорогими лицензиями. Начните с использования возможностей вашей текущей СУБД (PostgreSQL, MS SQL Server) и скриптов автоматизации. Главное - создать процесс, а не купить коробку.
Как внедрить governance и не убить скорость разработки
Самый большой страх разработчиков и аналитиков перед data governance - потеря скорости. «Мы будем месяц ждать согласования новой колонки в таблице!» - кричат они. Чтобы этого избежать, внедряйте концепцию «Data Mesh» или федеративного управления.
Суть проста: центральный отдел данных (Data Platform Team) предоставляет инфраструктуру и общие правила (как хранить, как защищать), а предметные области (Sales, Marketing, Logistics) отвечают за качество и семантику своих данных. Вы не запрещаете им менять структуру таблиц, вы требуете, чтобы изменения были задокументированы в каталоге и прошли автоматическую проверку на нарушение политик безопасности.
Внедрение должно идти итерациями:
- Аудит текущего состояния: Найдите самые критичные датасеты. Те, которые используются в финансовых отчетах или содержат ПДн.
- Назначение владельцев: У каждой важной таблицы должен быть живой человек, отвечающий за ее актуальность. Анонимные данные никому не нужны.
- Базовые политики: Настройте запрет на выгрузку «Строго конфиденциальных» данных без шифрования. Запретите прямой доступ к продакшену для аналитиков (дайте им витрины).
- Автоматизация: Подключите мониторинг логов доступа. Кто и когда читал таблицу с зарплатами? Если доступа нет неделю - отзывайте его.
Типичные ловушки и как их обойти
Даже с хорошими инструментами можно провалиться. Вот три грабли, на которые наступают чаще всего:
Ловушка №1: «Единый словарь» ради единого словаря. Компании тратят месяцы на описание каждого поля в базе, но никто этим не пользуется. Решение: документируйте только те метрики, которые вызывают споры или входят в KPI руководства. Остальное пусть описывается кодом (self-documenting code).
Ловушка №2: Игнорирование исторических данных. Вы настроили новые правила доступа, но старые архивы остались открытыми для всех. Хакер или любопытный стажер легко найдет там компромат. Решение: применяйте политики ко всему жизненному циклу данных, включая архивы и бэкапы.
Ловушка №3: Отсутствие обучения. Вы написали регламент, повесили его на внутренний портал и забыли. Сотрудники продолжают шарить файлы по почте. Решение: проводите короткие тренинги по безопасности данных раз в полгода. Показывайте кейсы утечек, произошедших из-за человеческих ошибок, а не взломов.
Нужен ли отдельный отдел для data governance в небольшой компании?
Нет, выделенный отдел обычно избыточен для компаний до 200 сотрудников. Достаточно назначить ответственного среди существующих специалистов (например, старшего аналитика или тимлида команды данных). Его задача - следить за соблюдением правил, а не писать код. Ключевое - закрепить эту функцию в должностных инструкциях и дать полномочия блокировать небезопасные процессы.
Как быстро внедрить RBAC, если сейчас все имеют доступ ко всему?
Не пытайтесь закрыть все сразу. Начните с принципа минимальных привилегий для новых пользователей. Старых сотрудников переведите в режим наблюдения: включите логирование запросов и посмотрите, кто реально обращается к каким таблицам. Через месяц вы увидите реальную картину и сможете создать точечные роли, не ломая работу тех, кому действительно нужен широкий доступ.
Что делать с данными в Excel, которые гуляют по почте?
Это самая сложная часть - теневые данные. Полностью запретить Excel нереально. Стратегия: перенести критичные отчеты в BI-систему (Power BI, Tableau, Superset), откуда их нельзя скачать целиком, а только смотреть визуально. Для рабочих файлов используйте DLP-системы (Data Loss Prevention), которые предупреждают сотрудника, если он пытается отправить файл с маркером «Конфиденциально» внешнему адресату.
Как обеспечить соответствие 152-ФЗ при использовании облачных сервисов?
Проверяйте локацию дата-центров провайдера. Сервис должен гарантировать хранение данных на территории РФ. Также убедитесь, что в договоре прописана ответственность оператора за обработку ПДн и предусмотрена возможность получения копий журналов доступа по запросу Роскомнадзора. Многие российские облака (Yandex Cloud, VK Cloud, Selectel) уже предоставляют сертификаты соответствия, которые можно использовать в своей отчетности.
Стоит ли покупать платные инструменты governance на старте?
На этапе стартапа или малого бизнеса лучше использовать встроенные функции СУБД и open-source каталоги (типа DataHub). Платные enterprise-решения оправданы, когда у вас более 50 источников данных, несколько десятков активных пользователей и строгие регуляторные требования. Сначала выстройте процессы руками, а автоматизацией займитесь, когда рутина станет невыносимой.