
Архитектура корпоративного DWH: как спроектировать хранилище данных
 ноя, 21 2026
Знаете это чувство, когда бизнес просит отчет за пять минут, а вы смотрите на SQL-запрос, который висит уже три часа? Или когда два отдела приносят данные, которые «почти одинаковые», но цифры расходятся на миллионы? Это не проблема Excel. Это проблема архитектуры. Data Warehouse (DWH) - это централизованное хранилище интегрированных данных, оптимизированное для аналитических запросов, а не для транзакций. Если ваш DWH построен криво, он превращается в кладбище таблиц. Если правильно - в источник истины для всей компании.
Почему операционные базы не тянут аналитику
Многие новички пытаются строить отчеты напрямую из OLTP-систем (например, из PostgreSQL или Oracle, где живет основной бизнес). Это ошибка. Операционные базы заточены под быстрые записи и обновления строк. Они нормализованы до третьей нормальной формы, чтобы избежать дублирования данных. Для аналитики это кошмар: чтобы получить сводку по продажам, нужно соединить (JOIN) десять таблиц, что убивает производительность.
DWH решает эту проблему через денормализацию. Здесь данные хранятся так, как их запрашивают аналитики, а не так, как их создает система. Но просто копировать таблицы недостаточно. Нужна четкая архитектура слоев, которая отделит сырые данные от готовых метрик.
Классические архитектурные подходы: Kimball vs Inmon
В мире проектирования DWH есть два гуру, чьи методы до сих пор определяют рынок. Выбор между ними зависит от скорости запуска и гибкости.
| Критерий | Kimball (Bottom-Up) | Inmon (Top-Down) |
|---|---|---|
| Стратегия | Начинаем с витрин данных (Data Marts), затем собираем общее хранилище. | Сначала строим единое enterprise-хранилище, потом питаем витрины. |
| Скорость внедрения | Быстрая. Можно запустить первый проект за 3-6 месяцев. | Долгая. Требуется 1-2 года на построение ядра. |
| Гибкость | Высокая. Легко добавлять новые источники и требования. | Низкая. Изменения в ядре требуют масштабных переработок. |
| Целевая аудитория | Бизнес-пользователи, которым нужны быстрые результаты. | Крупные корпорации со сложной интеграцией данных. |
На практике в 2026 году большинство компаний используют гибридный подход или смещаются к модели Data Lakehouse, но понимание слоистости остается критически важным.
Слоистая архитектура: путь данных
Чтобы DWH не превратился в хаос, данные должны проходить через четко определенные этапы трансформации. Представьте это как конвейер на заводе.
- Staging Area (Зона загрузки): Сюда попадают сырые данные из источников (CRM, ERP, логи веб-сайтов). Здесь нет никакой логики, кроме проверки целостности. Данные могут быть грязными, дублированными или в разных форматах.
- Integration Layer (Слой интеграции): Здесь происходит магия очистки и стандартизации. Например, если в CRM клиент называется "ООО Ромашка", а в бухгалтерии "Ромашка ООО", здесь они объединяются под одним уникальным ID. Этот слой часто называют ODS (Operational Data Store) или Silver Layer в современных стеках.
- Presentation Layer (Слой представления): Финальный этап. Здесь создаются звезды (Star Schema) или снежинки (Snowflake Schema), готовые для BI-инструментов вроде Power BI или Tableau. Аналитик видит понятные поля: "Дата продажи", "Сумма", "Регион".
Главная ошибка - пропускать слой интеграции. Когда аналитики сами пишут сложные SQL-запросы поверх сырых данных, каждый отдел получает свою версию правды. Итог: споры о том, чья цифра верная, вместо обсуждения стратегии бизнеса.
ETL против ELT: что выбрать в 2026 году?
Процесс переноса данных из источника в DWH называется ETL (Extract, Transform, Load) или ELT (Extract, Load, Transform). Разница принципиальна для стоимости и скорости.
ETL (Трансформируем перед загрузкой) - классический подход. Вы используете инструменты вроде Informatica или SSIS, чтобы очистить данные на промежуточном сервере, и только чистые данные грузите в DWH. Это экономит ресурсы хранилища, но требует мощных ETL-серверов и сложных пайплайнов.
ELT (Загружаем, потом трансформируем) - современный стандарт для облачных платформ. Мы загружаем сырые данные прямо в Snowflake, BigQuery или ClickHouse, а трансформацию делаем внутри самого хранилища с помощью SQL (часто через dbt). Почему это популярно? Потому что облачные хранилища масштабируются мгновенно. Вам не нужно гадать, сколько ресурсов выделить для ETL. Платформа сама справится с нагрузкой.
Если у вас малый или средний бизнес, выбирайте ELT. Это дешевле, быстрее и проще в поддержке. ETL имеет смысл только при жестких требованиях безопасности (данные не должны покидать локальную сеть в сыром виде) или при работе с очень специфическими legacy-системами.
Моделирование данных: Звезда или Снежинка?
Как структурировать таблицы в Presentation Layer? Два основных шаблона:
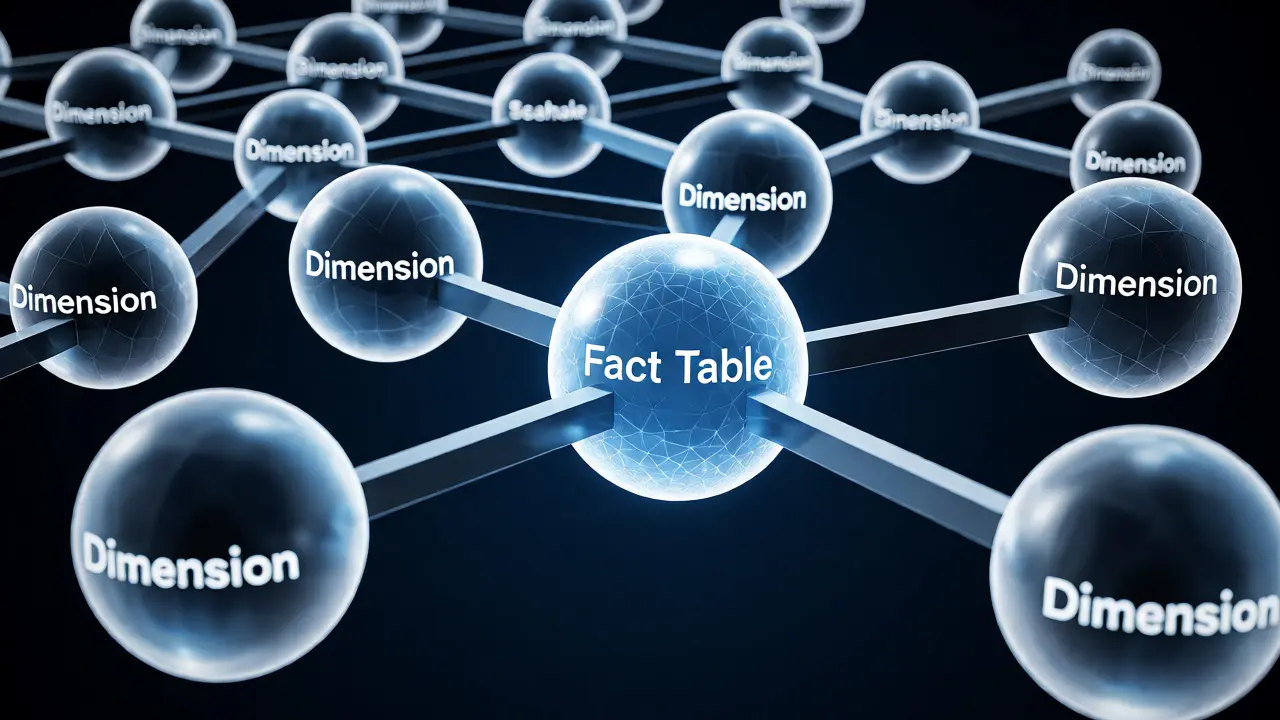
- Star Schema (Звезда): Одна центральная таблица фактов (например, "Продажи") и несколько денормализованных таблиц измерений ("Клиенты", "Товары", "Время"). Таблица "Клиенты" содержит все атрибуты клиента сразу, даже если они дублируются. Запросы просты и быстры.
- Snowflake Schema (Снежинка): Таблицы измерений нормализованы дальше. Вместо одной таблицы "Клиенты" может быть таблица "Клиенты" и отдельная таблица "Страны". Экономит место на диске, но усложняет JOIN-ы.
Для большинства корпоративных задач Star Schema выигрывает. Дисковое пространство сейчас дешевое, а время аналитика и скорость ответа BI-системы - дорогие. Не усложняйте схему без крайней необходимости.
Типичные ошибки при проектировании DWH
Даже опытные команды наступают на одни и те же грабли. Вот чего стоит избегать:
- Отсутствие единого словаря данных. Поле "Revenue" в одном отчете включает НДС, в другом - нет. Без документированного глоссария DWH бесполезен.
- Игнорирование истории изменений. Клиент изменил адрес. В OLTP базе старая запись перезаписывается. В DWH должна остаться история: "Адрес был X с 2020 по 2023, стал Y с 2024". Используйте Type 2 Slowly Changing Dimensions (SCD).
- Монолитные ETL-процессы. Если обновление всего DWH занимает 8 часов, вы не сможете обновлять данные чаще раза в сутки. Проектируйте инкрементальные загрузки.
- Смешивание ролей. Один человек пишет код, администрирует базу и объясняет бизнесу, почему цифры не сходятся. Разделяйте роли: Data Engineer отвечает за пайплайны, Data Analyst - за логику метрик.
Инструментарий современного DWH
Архитектура зависит от выбранных инструментов. Вот типичный стек для среднего бизнеса в России и СНГ:
| Компонент | Инструменты | Зачем нужен |
|---|---|---|
| Хранилище | Greenplum, ClickHouse, PostgreSQL (для малых объемов) | Хранение больших объемов исторических данных. |
| ETL/ELT | Airflow, dbt, Fivetran | Оркестрация процессов и трансформация SQL-кодом. |
| BI | Yandex DataLens, Visiology, Power BI | Визуализация и самообслуживаемая аналитика. |
Обратите внимание на dbt (data build tool). Он позволяет писать SQL-трансформации как модульный код, с контролем версий через Git. Это переводит работу с данными из уровня "ручной работы" в уровень инженерной культуры.
Практические шаги для старта
Не пытайтесь построить идеальный DWH сразу. Начните с малого:
- Выберите один бизнес-процесс (например, продажи).
- Определите ключевые метрики (выручка, маржинальность, LTV).
- Спроектируйте Star Schema для этого процесса.
- Настройте ежедневную инкрементальную загрузку.
- Подключите BI-инструмент и дайте доступ пользователям.
- Собирайте обратную связь и расширяйте модель на другие процессы (склад, маркетинг).
Помните: DWH - это живой организм. Он должен эволюционировать вместе с бизнесом, а не стать еще одной системой, которую никто не трогает годами.
Чем DWH отличается от Data Lake?
Data Lake хранит данные в исходном формате (текст, картинки, JSON) без строгой схемы. Он дешевле и подходит для машинного обучения и хранения архивов. DWH хранит структурированные, очищенные данные с жесткой схемой, оптимизированные для SQL-запросов и бизнес-отчетов. Часто их используют вместе: Lake как вход, DWH как выход для аналитиков.
Нужен ли DWH малому бизнесу?
Если у вас меньше 5 источников данных и простые отчеты, возможно, достаточно Excel или связки Google Sheets + Power BI. DWH становится необходим, когда количество таблиц превышает десятки, появляются конфликты данных между отделами, или отчеты формируются дольше нескольких часов.
Что такое Slowly Changing Dimensions (SCD)?
Это метод обработки изменений атрибутов во времени. SCD Type 1 перезаписывает старые значения (мы видим только текущее состояние). SCD Type 2 сохраняет историю, создавая новую запись с новыми датами начала и окончания действия. Для финансового анализа обычно требуется Type 2.
Как обеспечить качество данных в DWH?
Внедряйте автоматические проверки на этапе Staging: проверка типов данных, диапазонов значений, обязательных полей и уникальности ключей. Логируйте все исключения. Если данные не проходят проверку, они не должны попадать в Presentation Layer, иначе аналитики будут принимать решения на основе мусора.
Можно ли использовать ClickHouse как полноценное DWH?
Да, ClickHouse отлично подходит для DWH, особенно если преобладают агрегатные запросы и чтение больших объемов данных. Однако он слабее в UPDATE и DELETE операциях по сравнению с традиционными СУБД. Для сценариев с частым изменением небольших фрагментов данных лучше рассмотреть Greenplum или облачные решения типа Snowflake.